Högsta domstolen har nu meddelat sitt avgörande i målet Getty Images mot Stability AI, ett beslut som kommer att forma det rättsliga landskapet i takt med att AI utvecklas. Även om utfallet kan överklagas är det viktigt att förstå det prejudikat som nu har fastställts, eftersom beslutet ger viktig vägledning om hur brittisk lagstiftning ser på generativ AI, tillgång till sådan teknik online och det innehåll som den skapar.
Hur hamnade vi här?
Getty Images är ett globalt företag inom visuella medier – framför allt en ledande leverantör av stockbilder.
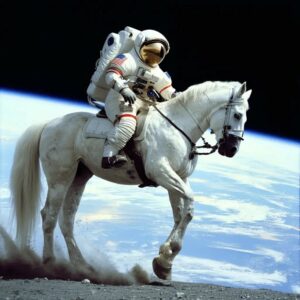
Stability AI är i sin tur ett Londonbaserat företag som utnyttjar en generativ AI-modell som kallas Stable Diffusion. Stable Diffusion är utformat för att ta emot en prompt från en användare och generera en bild utifrån den prompten.
Uppgift: ”Ett fotografi av en astronaut som rider på en häst”
Bild genererad av Stable Diffusion:
För att träna sin modell använde Stability AI över 5 miljarder bilder och tillhörande bildtexter, däribland bilder och bildtexter som ägs av Getty Images.
Getty Images väckte fem talan mot Stability AI vid High Court år 2023:
- En huvudsaklig anklagelse om upphovsrättsintrång, enligt vilken Stability AI ska ha kopierat Gettys upphovsrättsskyddade bilder under träningen av Stable Diffusion;
- Sekundär upphovsrättsintrång, där det hävdas att Stability AI importerade en ”artikel” som utgjorde en upphovsrättsintrångande kopia av Gettys verk;
- Intrång i den särskilda databasrättigheten genom påstådd olaglig utvinning av bilder från Gettys bildbibliotek;
- Varumärkesintrång, där det hävdas att de AI-genererade resultaten innehöll Gettys varumärkesskyddade vattenstämpel; samt
- Anklagelse om varumärkesintrång, med hänvisning till att förekomsten av AI-genererade vattenstämplar skulle kunna vilseleda konsumenterna.
Getty drog tillbaka sina yrkanden om primär upphovsrättsintrång och sui generis -rättigheter till databaser under rättegången, eftersom Getty inte kunde bevisa att träningen och skrapningen hade ägt rum i Storbritannien.
Vad är en AI-modell och en modellvikt?
Innan vi fortsätter är det bra att kort förklara vad som menas med begreppen ”AI-modell” och ”modellvikt”, eftersom de förekommer genomgående i beslutet.
En AI-modell innehåller miljontals, om inte miljarder, numeriska värden, så kallade modellvikter. Modellvikterna används för att omvandla en indata och generera en utdata. Varje AI-modell har dessutom en arkitektur som anger den exakta händelseföljden som krävs för att omvandla indatan och generera utdata.
När en AI-modell (som Stable Diffusion) tränas analyserar den stora mängder data (till exempel bildtexter) och justerar gradvis sina vikter så att den kan generera bilder som stämmer överens med bildtexten.
Ett bra sätt att se på detta är att varje modellvikt talar om för modellen hur starkt en egenskap (som en färg, form eller ett ordmönster) bör påverka en annan. Tillsammans utgör alla vikter modellens interna ”kunskap”; även om dessa modellvikter är resultatet av en analys av miljontals exempel är de endast en samling siffror och lagrar inte direkt kopior av träningsdata.
Under träningen genererar AI-modellen, varje gång den tar emot en bildtext från träningsdatauppsättningen, en bild och jämför hur väl den stämmer överens med den faktiska bilden som hör till bildtexten. Den använder dessa skillnader för att justera alla modellvikter.
Upphovsrätt
Gettys huvudsakliga yrkanden avseende upphovsrätt och databasrätt avgjordes aldrig fullständigt. Yrkandet avseende ”träning” föll eftersom Getty inte kunde visa att någon träning hade ägt rum i Storbritannien, och yrkandet avseende ”resultat” blev rent akademiskt efter att de specifika uppmaningar som åberopats hade blockerats. Detta innebar att Getty kvarstod med yrkanden om sekundär upphovsrättsintrång och varumärkesintrång.
Den sekundära talan om upphovsrättsintrång handlade om huruvida Stable Diffusion -modellen kunde betraktas som en ”intrångsgörande kopia”. Domstolen avvisade detta. Även om lagen kan tillämpas på immateriella föremål utgör en AI-modell som varken lagrar eller återger de ursprungliga träningsbilderna inte en intrångsgörande kopia.
Domstolen lade fram en strikt och positivistisk tolkning av lagen, grundad på det faktum att de aktuella modellvikterna avser inlärd information, inte lagrade reproduktioner.
Domstolen fastslog att nedladdning av modellvikter till Storbritannien skulle kunna utgöra import av en immateriell vara. Detta har dock endast betydelse om varan i sig utgör ett intrång, vilket inte var fallet med modellen. Däremot innebär tillgång via webbhotell (där användarna kör modellen online utan att ladda ner den) ingen import alls.
Följaktligen ogillades den sekundära upphovsrättsanspråket.
Varumärken
Getty fick endast delvis medhåll i sin varumärkesansökan. Domstolen konstaterade att intrång hade skett i samband med vissa tidigare versioner av Stable Diffusion -modellen som genererade bilder med vattenstämplar från Getty Images eller iStock. Dessa konstateranden begränsade sig till ett fåtal exempel hämtade från äldre versioner av modellen, och gällde inte de nyare versionerna av verktyget. Exempel på återgivningen av vattenstämplarna kan ses nedan:
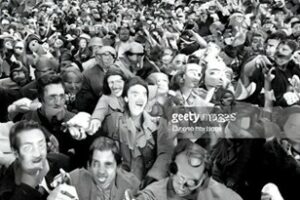
Domstolen var noga med att inte dra för vid slutsatser av dessa konstateranden. Den vägrade att godta att förekomsten av vattenmärken i ett fåtal tidiga resultat visade på ett systemomfattande problem i alla versioner av Stable Diffusion eller i det bredare resultatutrymmet. Senare versioner av modellen innehöll filtreringsmekanismer utformade för att upptäcka och ta bort vattenmärken, och de bevis som lagts fram för domstolen tydde på att dessa i stort sett var effektiva. Getty kunde inte heller lägga fram exempel från Storbritannien på att vattenmärken återfanns i nyare versioner.
Getty hävdade att Stability hade utnyttjat eller skadat varumärket Getty Images anseende. Detta ledde inte till något resultat, eftersom det saknades bevis för otillbörlig fördel eller skada, och domstolen konstaterade att bilder med vattenstämpel är oönskade och vanligtvis kasseras.
Varför segern i varumärkesmålet var begränsad
Domstolens dom till Gettys fördel var snäv, vilket återspeglar både den begränsade bevisningen och hur generativa AI-system utvecklas.
När det gäller bevis krävde domstolen tydliga, verifierbara exempel på intrångsgörande resultat kopplade till specifika modellversioner och plattformar. Allmänna påståenden om hur modellen fungerade räckte inte.
I senare versioner av Stability-modellen infördes effektiva åtgärder, såsom vattenmärkesfilter och bättre säkerhetsmekanismer. Följaktligen begränsades resultatet till ett fåtal historiska exempel, snarare än att det rörde sig om någon allmän brist i modellen.
Risken för varumärkesintrång kvarstår, men rättighetsinnehavarna kan hantera den genom att samla in tydliga, versionsspecifika bevis på intrångsgörande material. Framgången beror på att man kan påvisa direkta kopplingar mellan det intrångsgörande materialet och utvecklarens plattform, snarare än att förlita sig på allmänna påståenden om modellens beteende i stort.
Konsekvenser för AI och immateriella rättigheter
När det gäller upphovsrätt är budskapet tydligt. Modeller kommer inte att betraktas som upphovsrättsintrång om de inte faktiskt lagrar reproduktioner av träningsdata. Lagen om upphovsrätt, mönster och patent (CDPA) är svår att tillämpa på träning som sker utanför Storbritannien, och modeller som hostas faller utanför begreppet ”import”. Domstolen klargjorde också att en utvidgning av upphovsrätten till att omfatta denna typ av teknik är en fråga för parlamentet, inte för domstolarna. I sin tur anger domen några praktiska åtgärder som utvecklare av generativ AI kan vidta för att undvika upphovsrättsintrång.
När det gäller varumärken har rättighetsinnehavarna fortfarande ett visst inflytande, men endast i de fall då ett varumärke återges tydligt och specifikt. I takt med att tekniken utvecklas och kraftfullare filter införs blir det allt svårare att bevisa att data som innehåller ett varumärke har använts i träningen. Det är numera betydligt mindre troligt att utdata återger vattenmärken eller logotyper. Med effektiva filter på plats kan utvecklare av generativ AI förhindra denna typ av intrång.
Ett eventuellt överklagande skulle behöva ta upp domstolens centrala slutsats att modeller som varken lagrar eller återger upphovsrättsskyddade verk inte utgör intrångsgörande kopior, samt domstolens noggranna bedömning av bevisningen i varumärkesmålet. Under tiden kommer debatten kring text- och datamining samt träning av AI sannolikt att tillta. För närvarande är Storbritanniens ståndpunkt tydlig: inget sekundärt upphovsrättsintrång för modeller som endast lagrar vikter, och ett begränsat varumärkesansvar som är begränsat till tydliga fall där vattenmärken och logotyper återges.
Om ni vill diskutera denna fråga vidare är ni välkomna att kontakta författarna – Jacob Larking ochFrancesco Di Lallo – eller er vanliga advokat hos Barker Brettell.
”Domen ger viktiga riktlinjer för hur brittisk lagstiftning ser på generativ AI, tillgång till sådan teknik på nätet och det innehåll som den skapar”