高等法院现已就 “盖蒂图片社诉Stability AI”一案中作出了裁决,该裁决将塑造人工智能发展过程中的法律格局。尽管该裁决结果可能面临上诉,但理解当前确立的判例至关重要,因为该裁决就英国法律如何看待生成式人工智能、对其的在线访问以及其生成的内容提供了重要指导。
我们是怎么走到这一步的?
盖蒂图片社(Getty Images)是一家全球性的视觉媒体公司——尤其是图片库图片的主要授权方。
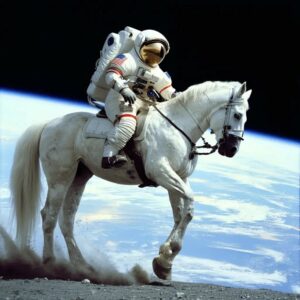
而Stability AI是一家总部位于伦敦的公司,它利用了一个名为Stable Diffusion的生成式人工智能模型。Stable Diffusion的设计原理是:用户输入提示词后,系统便会根据该提示生成图像。
提示词:“一张宇航员骑马的照片”
由Stable Diffusion 生成的图像:
为了训练其模型,Stability AI使用了超过 50 亿张图片及相应的图注,其中包括盖蒂图片社(Getty Images)拥有的图片和图注。
盖蒂图片社于2023年向高等法院对Stability AI提出了五项诉讼:
- 主要版权侵权指控称,Stability AI在训练Stable Diffusion 过程中抄袭了盖蒂图片社的受版权保护的图像;
- 关于Stability AI导入了一篇作为盖蒂作品侵权复制品的“文章”的间接版权侵权指控;
- 涉嫌非法抓取盖蒂图片库,侵犯“SuiGeneris”数据库权;
- 商标侵权指控,称人工智能生成的内容中包含盖蒂(Getty)的商标水印;以及
- 以“冒充”为由,声称AI生成的水印可能会误导消费者。
在庭审过程中,盖蒂撤回了关于主要版权侵权和数据库特有权利的指控,因为盖蒂无法证明训练和数据抓取行为是在英国境内发生的。
什么是AI模型和模型权重?
在继续之前,有必要简要说明“AI模型”和“模型权重”这两个术语的含义,因为它们在整个裁决中都会出现。
一个人工智能模型包含数百万甚至数十亿个数值,这些数值被称为模型权重。模型权重用于对输入进行转换并生成输出。每个人工智能模型还具有一种架构,该架构向模型指定了将输入转换为输出所需的确切操作序列。
在训练人工智能模型(如Stable Diffusion)时,它会分析大量数据(例如图片说明),并逐步调整这些权重,从而能够准确生成与该说明相关的图像。
一个有帮助的理解方式是:每个模型权重都告诉模型,一个特征(如颜色、形状或词汇模式)应该对另一个特征产生多大的影响。所有权重综合起来,就构成了模型的内部“知识”;虽然这些模型权重是通过分析数百万个示例得出的,但它们仅仅是一组数字,并不直接存储训练数据的副本。
在训练过程中,每当人工智能模型从训练数据集中读取一条图像说明时,它就会生成一张图像,并比较该图像与该说明对应的实际图像的吻合程度。它利用这些差异来调整模型的所有权重。
版权
盖蒂公司关于版权和数据库权的主要主张从未得到最终裁决。由于盖蒂公司无法证明在英国境内曾进行过任何“训练”,其“训练”主张因此被驳回;而在其依据的具体提示被封禁后,“输出”主张也沦为纯理论探讨。这使得盖蒂公司仅剩下关于二次版权侵权和商标侵权的主张。
关于次要版权侵权的主张,焦点在于Stable Diffusion模型是否可被视为“侵权复制品”。法院驳回了这一主张。尽管该法律可适用于无形物品,但一个既不存储也不复制原始训练图像的人工智能模型,并不构成侵权复制品。
法院基于相关模型权重记录的是已学到的信息,而非存储的复制品这一事实,对法律作出了严格且实证主义的解释。
法院裁定,将模型权重下载至英国可能构成无形物品的进口。然而,这仅在该物品本身构成侵权的情况下才具有意义,而该模型并不构成侵权。相比之下,托管访问(即用户在线运行模型而无需下载)则完全不涉及进口。
因此,关于次要版权的主张未获支持。
商标
盖蒂在商标主张方面仅部分胜诉。法院认定,Stable Diffusion模型的某些早期版本生成的图像中带有盖蒂图片社(Getty Images)或iStock水印,构成侵权。这些认定仅限于从较早版本模型中选取的少数几个例子,并不涉及该工具的新版本。水印复现的示例如下:
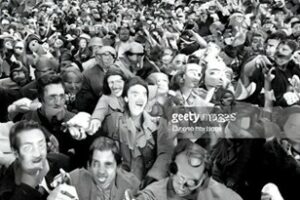
法院谨慎地避免将这些调查结果过度推断。法院拒绝接受这样一种观点,即少数早期生成的图像中存在水印,就表明Stable Diffusion的所有版本或更广泛的生成结果中存在系统性问题。该模型的后期版本已纳入旨在检测和移除水印的过滤机制,且提交给法院的证据表明这些机制在很大程度上是有效的。此外,盖蒂公司也未能提供基于英国的新版本生成图像中出现水印复现的实例。
盖蒂公司主张,Stability公司利用或损害了“盖蒂图片社”商标的声誉。该主张未获支持,因为缺乏关于不正当获利或损害的证据;法院指出,带有水印的图片不受欢迎,通常会被丢弃。
为何此次商标诉讼的胜诉范围有限
法院作出有利于盖蒂的裁决,但裁决范围较为有限,这既反映了证据的有限性,也反映了生成式人工智能系统的发展特点。
关于证据,法院要求提供与具体模型版本和平台相关的、清晰且可核实的侵权输出实例。仅对模型行为的一般性陈述是不够的。
“稳定性”模型的后续版本引入了有效解决方案,例如水印滤波器和更完善的防护措施。因此,这一发现仅限于少数历史案例,而非该模型存在任何普遍缺陷。
商标风险依然存在,但权利人可以通过收集针对特定版本的侵权成果的明确证据来应对。能否胜诉取决于能否证明侵权内容与开发者平台之间存在直接关联,而非依赖于对模型一般行为的笼统指控。
对人工智能和知识产权的影响
就版权而言,这一立场非常明确。除非模型实际存储了训练数据的复制品,否则不会被视为侵权复制品。《版权、设计与专利法》(CDPA)通常不适用于在英国境外进行的训练,且托管模型不属于“进口”的范畴。 法院还明确指出,将版权法扩展至涵盖此类技术属于议会的职权范围,而非法院的职责。与此同时,该判决还列举了生成式人工智能开发者为避免侵犯版权可采取的一些实际措施。
对于商标,权利人仍掌握一定的话语权,但仅限于商标被清晰、具体地复现的情况。随着技术的发展和更强效过滤机制的引入,要证明包含商标的数据曾被用于训练正变得越来越困难。如今,生成的内容极少会复现水印或徽标。只要部署有效的过滤机制,生成式人工智能开发者就能防止此类侵权行为的发生。
任何潜在的上诉都需针对法院的关键裁定——即不存储或再现受版权保护作品的模型不构成侵权复制品——以及法院在商标主张中对证据采取的审慎态度。与此同时,围绕文本和数据挖掘以及人工智能训练的讨论预计将愈演愈烈。目前,英国的立场十分明确:仅存储权重参数的模型不构成二次版权侵权,而商标责任仅限于水印和徽标被再现的明确情形。
如果您希望进一步讨论此事,请随时联系本文作者——雅各布·拉金(Jacob Larking)和弗朗切斯科·迪·拉洛(Francesco Di Lallo)——或您惯常联系的巴克·布雷特尔律师事务所(Barker Brettell)律师。
“该裁决就英国法律如何看待生成式人工智能、对其的在线访问以及它们所生成的内容提供了重要指导”