La Haute Cour a désormais rendu son jugement dans l’affaire affaire Getty Images c. Stability AI, une décision qui va façonner le paysage juridique à mesure que l’IA se développe. Bien que cette décision puisse faire l’objet d’un recours, il est important de comprendre le précédent ainsi établi, car elle fournit des indications importantes sur la manière dont le droit britannique appréhende l’IA générative, l’accès en ligne à ces technologies et les contenus qu’elles créent.
Comment en sommes-nous arrivés là ?
Getty Images est une entreprise internationale spécialisée dans les médias visuels, et plus particulièrement l'un des principaux fournisseurs d'images d'archives.
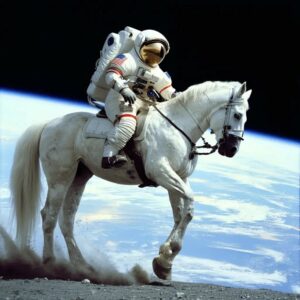
De son côté, Stability AI est une entreprise basée à Londres qui exploite un modèle d'IA générative appelé « Stable Diffusion ». Stable Diffusion est conçu pour recevoir une consigne de la part d'un utilisateur et générer une image à partir de cette consigne.
Sujet : « Une photo d'un astronaute à cheval »
Image générée par Stable Diffusion:
Pour entraîner son modèle, Stability AI a utilisé plus de 5 milliards d'images et de légendes correspondantes, dont certaines appartenaient à Getty Images.
En 2023, Getty Images a introduit cinq actions en justice contre Stability AI devant la Haute Cour :
- Une première accusation de violation du droit d'auteur, selon laquelle Stability AI aurait copié des images protégées par le droit d'auteur de Getty lors de l'entraînement de Stable Diffusion;
- Une accusation de contrefaçon secondaire, selon laquelle Stability AI aurait importé un « article » constituant une copie contrefaisante des œuvres de Getty;
- Violation du droit sur les bases de données « sui generis » alléguant le « scraping » illégal des bibliothèques d'images de Getty;
- Une violation de marque déposée, au motif que les contenus générés par l'IA comportaient le filigrane de la marque déposée de Getty; et
- Action en contrefaçon fondée sur le fait que la présence de filigranes générés par l'IA pourrait induire les consommateurs en erreur.
Getty a abandonné, au cours du procès, ses allégations de violation du droit d'auteur et des droits sui generis sur les bases de données, car l'entreprise n'a pas pu prouver que l'entraînement et le « scraping » avaient eu lieu au Royaume-Uni.
Qu'est-ce qu'un modèle d'IA et un poids de modèle ?
Avant de poursuivre, il est utile d'expliquer brièvement ce que l'on entend par les termes « modèle d'IA » et « poids du modèle », car ils apparaissent tout au long de la décision.
Un modèle d'IA contient des millions, voire des milliards, de valeurs numériques, appelées « poids du modèle ». Les poids du modèle servent à transformer une entrée pour produire une sortie. Chaque modèle d'IA possède également une architecture qui lui indique la séquence exacte d'événements nécessaires pour transformer l'entrée et produire la sortie.
Lorsqu'un modèle d'IA (comme Stable Diffusion) est entraîné, il analyse une grande quantité de données (telles que des légendes d'images) et ajuste progressivement ses paramètres afin de pouvoir générer avec précision des images correspondant à la légende.
Une façon utile d'envisager cela est de considérer que chaque poids du modèle indique à celui-ci dans quelle mesure une caractéristique (comme une couleur, une forme ou une séquence de mots) doit influencer une autre. Une fois combinés, tous ces poids constituent la « connaissance » interne du modèle ; bien que ces poids résultent de l'analyse de millions d'exemples, ils ne sont qu'un ensemble de chiffres et ne stockent pas directement de copies des données d'apprentissage.
Au cours de l'entraînement, chaque fois que le modèle d'IA reçoit une légende d'image issue de l'ensemble de données d'entraînement, il génère une image et évalue dans quelle mesure celle-ci correspond à l'image réelle associée à la légende. Il utilise ces différences pour ajuster tous les poids du modèle.
Droits d'auteur
Les principales allégations de Getty relatives au droit d'auteur et au droit sur les bases de données n'ont jamais fait l'objet d'une décision définitive. L'allégation relative à la « formation » a été écartée, car Getty n'a pas pu démontrer qu'une formation avait eu lieu au Royaume-Uni, et celle relative au « résultat » est devenue purement théorique après que les consignes spécifiques invoquées ont été bloquées. Il ne restait donc à Getty que les allégations de contrefaçon secondaire du droit d'auteur et de contrefaçon de marque.
Le chef d'accusation secondaire pour contrefaçon portait sur la question de savoir si le modèle Stable Diffusion pouvait être considéré comme une « copie contrefaisante ». La Cour a rejeté cet argument. Bien que la loi puisse s'appliquer à des éléments incorporels, un modèle d'IA qui ne stocke ni ne reproduit les images d'entraînement originales ne constitue pas une copie contrefaisante.
La Cour a adopté une interprétation stricte et positiviste de la loi, en se fondant sur le fait que les poids des modèles en question correspondaient à des informations acquises, et non à des reproductions enregistrées.
La Cour a estimé que le téléchargement de poids de modèles au Royaume-Uni pouvait s'apparenter à l'importation d'un bien incorporel. Toutefois, cela n'a d'importance que si le bien en question constitue en soi une contrefaçon, ce qui n'était pas le cas de ce modèle. En revanche, l'accès hébergé (dans le cadre duquel les utilisateurs utilisent le modèle en ligne sans le télécharger) n'implique aucune importation.
En conséquence, la demande secondaire relative au droit d'auteur a été rejetée.
Marques déposées
Getty n'a obtenu gain de cause que partiellement dans le cadre de son action en contrefaçon de marque. La Cour a constaté une contrefaçon concernant certaines versions antérieures du modèle Stable Diffusion qui généraient des images comportant les filigranes « Getty Images » ou « iStock ». Ces conclusions se limitaient à une poignée d'exemples tirés d'anciennes versions du modèle, et non aux éditions plus récentes de l'outil. Vous trouverez ci-dessous des exemples de reproduction de ces filigranes :
La Cour s’est gardée de généraliser ces conclusions. Elle a refusé d’admettre que la présence de filigranes dans quelques-unes des premières images générées démontrait l’existence d’un problème systémique touchant l’ensemble des versions de Stable Diffusion ou l’espace de sortie au sens large. Les versions ultérieures du modèle intégraient des mécanismes de filtrage destinés à détecter et à supprimer les filigranes, et les éléments de preuve présentés à la Cour suggéraient que ceux-ci étaient largement efficaces. Getty n’a par ailleurs pas été en mesure de produire des exemples, provenant du Royaume-Uni, de reproduction de filigranes issus des versions plus récentes.
Getty a fait valoir que Stability avait exploité ou porté atteinte à la réputation de la marque Getty Images. Cet argument n'a pas été retenu, faute de preuves d'un avantage indu ou d'un préjudice ; le tribunal a en effet souligné que les images comportant un filigrane sont indésirables et sont généralement écartées.
Pourquoi cette victoire en matière de marque a été limitée
La décision de la Cour en faveur de Getty était restreinte, ce qui s’explique à la fois par le caractère limité des éléments de preuve et par la manière dont les systèmes d’IA générative se développent.
En ce qui concerne les éléments de preuve, la Cour a exigé des exemples clairs et vérifiables de résultats contrefaisants liés à des versions et à des plateformes spécifiques du modèle. Des affirmations générales sur le comportement du modèle ne suffisaient pas.
Les versions ultérieures du modèle « Stability » ont intégré des corrections efficaces, telles que des filtres de filigrane et des mesures de sécurité renforcées. En conséquence, cette constatation s’est limitée à quelques exemples historiques et n’a pas révélé de faille générale du modèle.
Le risque lié aux marques reste présent, mais les titulaires de droits peuvent y faire face en rassemblant des preuves claires et spécifiques à chaque version des contenus contrefaisants. Le succès dépendra de la capacité à démontrer l’existence de liens directs entre le contenu litigieux et la plateforme du développeur, plutôt que de s’appuyer sur des allégations générales concernant le comportement global du modèle.
Conséquences pour l'IA et la propriété intellectuelle
En matière de droit d’auteur, le message est clair : les modèles ne seront pas considérés comme des copies contrefaites, à moins qu’ils ne stockent effectivement des reproductions des données d’entraînement. La loi sur le droit d’auteur, les dessins et modèles et les brevets (CDPA) ne s’applique pas facilement à l’entraînement qui a lieu en dehors du Royaume-Uni, et les modèles hébergés ne relèvent pas de la notion d’« importation ». La Cour a également précisé que l’extension de la législation sur le droit d’auteur à ce type de technologie relevait de la compétence du Parlement, et non des tribunaux. Par ailleurs, l’arrêt énonce certaines mesures pratiques que les développeurs d’IA générative peuvent prendre pour éviter toute violation du droit d’auteur.
En matière de marques, les titulaires de droits disposent encore d’une certaine marge de manœuvre, mais uniquement lorsque la marque est reproduite de manière claire et spécifique. À mesure que la technologie évolue et que des filtres plus performants sont mis en place, il devient de plus en plus difficile de prouver que des données contenant une marque ont été utilisées lors de l’apprentissage. Les résultats sont désormais bien moins susceptibles de reproduire des filigranes ou des logos. Grâce à la mise en place de filtres efficaces, les développeurs d’IA générative peuvent empêcher ce type de contrefaçon.
Un éventuel recours devrait porter sur la conclusion principale de la Cour selon laquelle les modèles qui ne stockent ni ne reproduisent d’œuvres protégées par le droit d’auteur ne constituent pas des copies contrefaites, ainsi que sur son approche rigoureuse en matière de preuve dans le cadre de l’action en contrefaçon de marque. Dans l’intervalle, le débat autour de l’exploration de textes et de données et de l’entraînement des IA devrait s’intensifier. Pour l’instant, la position du Royaume-Uni est claire : il n’y a pas de contrefaçon secondaire du droit d’auteur pour les modèles qui se contentent de stocker des poids, et la responsabilité en matière de marque est limitée aux cas manifestes où des filigranes et des logos sont reproduits.
Si vous souhaitez approfondir cette question, n'hésitez pas à contacter les auteurs – Jacob Larking etFrancesco Di Lallo – ou votre avocat habituel chez Barker Brettell.
« Cette décision fournit des indications importantes sur la manière dont le droit britannique appréhende l'IA générative, l'accès à ces technologies en ligne et les contenus qu'elles créent. »